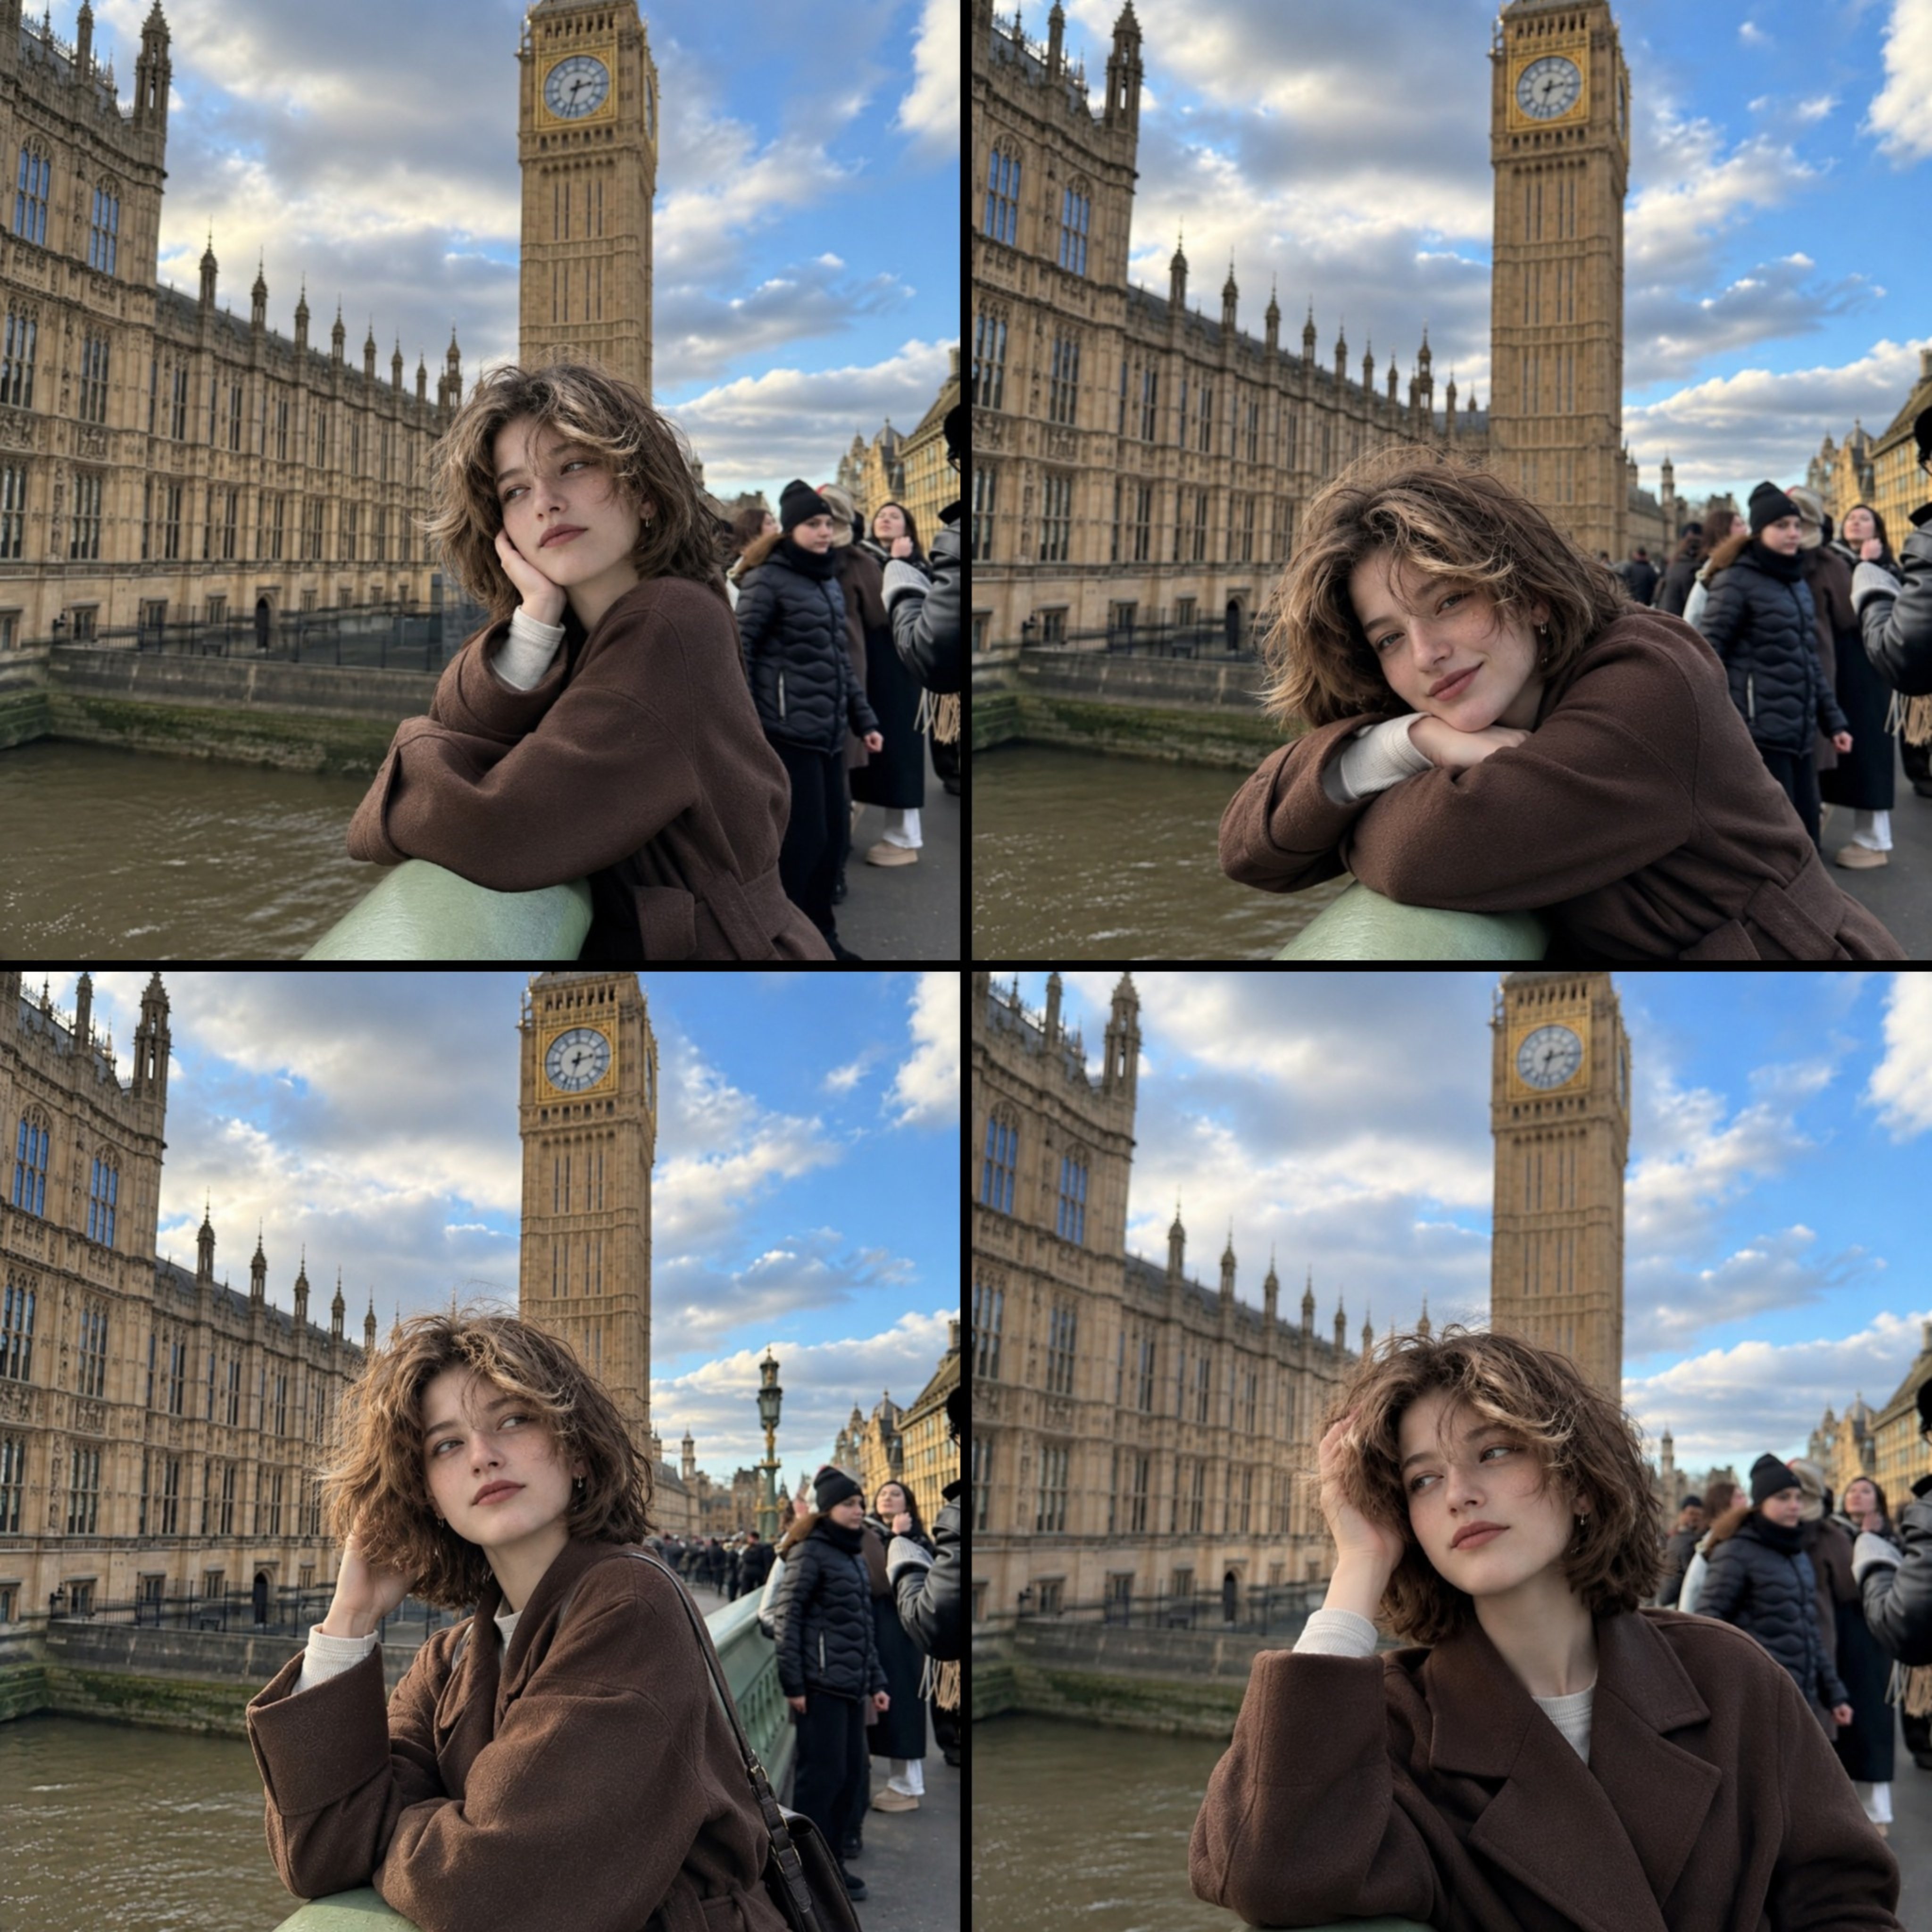
ウェストミンスター橋2x2フォトコラージュ
 GPT Image 2.5OpenAIimage
ロンドンのウェストミンスター橋で撮影された、同じ若い女性を4つのパネルすべてに起用したリアルな2×2フォトコラージュを作成する。背景にはビッグ・ベンと国会議事堂を配置する。 キャラクターの一貫性:4枚すべての写真で、まったく同じ顔のアイデンティティ、顔の特徴、そばかす、短く無造作なライトブラウンの髪、髪型、肌の色、体のプロポーションを維持すること。 服装:ダークチョコレートブラウンのオーバーサイズウールコート、その下にクリーム色のニットセーター、小さなシルバーのイヤリング。 パネル1、左上:女性が緑色の橋の手すりにもたれかかり、片手に頬をのせて、カメラから少し視線をそらしている。 パネル2、右上:手すりの上で組んだ腕にあごをのせ、微妙な微笑みを浮かべてカメラをまっすぐ見つめている。 パネル3、左下:手すりに横向きに座るかもたれかかり、髪にそっと触れながら遠くを見つめている。 パネル4、右下:手すりのそばに立ち、片手で髪をかき上げながら、物思いにふけって横を見ている。 環境:象徴的なビッグ・ベン、ウェストミンスター宮殿の精緻なゴシック建築、テムズ川、緑色の橋の手すり、冬服を着た自然にぼやけた観光客。 写真スタイル:超リアルな旅行写真、自然な表情、本物の肌の質感、柔らかな冬の日差し、一部雲がかかった青空、リアルな色合い、自然なスナップ風の編集写真、繊細な被写界深度。 レイアウト:完璧な2×2の正方形コラージュ、4枚の同じサイズの写真、細い黒の区切り線、一貫したカラーグレーディングとライティング。テキストなし、ウォーターマークなし、余分なパネルなし。 アスペクト比:1:1、高解像度、フォトリアル。
詳細情報
- タイプ
- AI 画像プロンプト
- アスペクト比
- 1:1
- 更新日
- 2026/11/09
このプロンプトの使い方
- 1上のコピーボタンでプロンプト全文をコピーします。
- 2OpenAI の GPT Image 2.5、または近いスタイルに対応した画像生成ツールを開きます。
- 3プロンプトを貼り付け、被写体やスタイルのキーワードを自分のイメージに置き換えます。
- 4作例の設定(1:1 · Street Photography · Realistic · Portrait)に合わせて生成し、少しずつ調整を重ねます——わずかな言い回しの違いで結果が大きく変わります。
よくある質問
この画像はどの AI モデルで生成されましたか?
この画像は OpenAI の GPT Image 2.5 で生成されました。ページ上のプロンプトが、生成に使われた原文そのものです。
このプロンプトはどんな設定を使っていますか?
作例は GPT Image 2.5 で、次の設定で生成されました:1:1 · Street Photography · Realistic · Portrait。同じ設定を使うと最も近い結果が得られます。
似た結果を得るにはどうすればいいですか?
まずプロンプトをそのままコピーし、スタイル・ライティング・構図のキーワードは残して被写体だけ置き換えます。出力は毎回変わるので、数回生成して選びましょう。
このプロンプトを改変してもいいですか?
もちろんです。プロンプトは出発点として使うのが最適——記述語やアスペクト比、スタイルタグを調整して、自分だけの作品に仕上げてください。